NXDOMAIN : diagnostiquer une anomalie DNS
Distinguez nom inexistant, cache négatif, filtrage et activité suspecte avant de transformer des erreurs NXDOMAIN en incident de sécurité.
 Équipe isMalicious
Une hausse de NXDOMAIN signifie que davantage de recherches DNS reçoivent une réponse de nom inexistant. Pour un SOC, la question utile est de savoir quel équipement recherche quels noms, par quel résolveur et depuis quel changement. Un compteur isolé ne permet de distinguer ni une panne applicative, ni une politique de blocage, ni un programme suspect.
Le diagnostic commence avec une réponse complète et un poste identifié. Il se termine par une décision assortie de preuves : corriger une configuration, expliquer un filtrage, poursuivre une investigation ou préciser ce qui manque encore.
Lire le résultat exact de la résolution
Une réponse vide ne signifie pas automatiquement NXDOMAIN. Relevez le code de réponse, le type demandé, les sections de réponse et d’autorité, ainsi que l’adresse du serveur interrogé. Avec un outil comme dig, évitez d’abord la sortie abrégée qui masque ces champs.
La RFC 2308 sur le cache négatif distingue NXDOMAIN, qui concerne l’absence du nom, de NODATA, qui correspond à un nom existant sans donnée du type demandé. Elle précise aussi qu’un NXDOMAIN peut concerner la cible finale d’un CNAME. Ces différences changent la cible à examiner.
Dans cet exemple fictif, api.service.example existe comme alias, mais son ancienne destination ne résout plus :
question : api.service.example. A
réponse : api.service.example. CNAME ancien.service.example.
statut : NXDOMAIN
L’enquête porte ici sur ancien.service.example, puis sur la configuration qui conserve cet alias. Déclarer tout le domaine service.example inexistant conduirait au mauvais diagnostic. Un SERVFAIL demande encore une autre analyse : le serveur n’a pas pu mener la résolution à bien.
Reconstituer le trajet du poste au résolveur
Notez le résolveur réellement utilisé au moment de l’événement. Le DNS du système, celui du navigateur, le VPN et une passerelle d’entreprise peuvent suivre des chemins différents. Une commande lancée sur votre ordinateur ne reproduit pas nécessairement la situation du poste concerné.
Conservez pour chaque observation : heure UTC, actif, nom complet, type de requête, résolveur, code de réponse et processus lorsqu’il est collecté. Ajoutez le réseau d’origine et l’état du VPN. Ces données rendent une comparaison reproductible et évitent de confondre deux vues DNS légitimes.
Pour une zone interne, interrogez uniquement les serveurs prévus par votre architecture. Envoyer son nom à un résolveur public révèle une information interne sans répondre au problème de la vue privée. Le guide sur la surveillance du DNS chiffré aide à comprendre pourquoi certaines requêtes échappent au point de collecte habituel.
Vérifier si le refus vient d’une politique
Un produit de filtrage peut présenter un résultat négatif au client. Consultez son journal de décisions et recherchez le nom exact, le poste, l’heure et la règle correspondante. Une correspondance avec une liste de blocage constitue une explication à confirmer, pas une propriété intrinsèque du domaine.
Si le résolveur fournit des Extended DNS Errors, enregistrez-les. La RFC 8914 prévoit notamment des indications de blocage et de filtrage qui complètent le code DNS. Leur absence ne prouve pas qu’aucune politique n’a été appliquée : le produit ou le chemin de collecte peut ne pas les transmettre.
Comparez ensuite le résultat avec une résolution autorisée depuis un point sans cette politique, si le domaine est public. Documentez cette différence sans contourner le blocage pour visiter le site. Vous cherchez l’origine de la réponse, pas à démontrer que la destination est sûre.
Départager cache négatif et configuration cassée
Un changement DNS peut être correct côté autorité tandis que certains clients voient encore l’échec précédent. Capturez la réponse du résolveur et celle des serveurs faisant autorité, avec leurs heures et les informations SOA disponibles. Répétez après un délai cohérent avec le cache observé.
Ne videz pas tous les caches avant de conserver la première observation. Cette action peut rétablir le service, mais elle retire une pièce qui expliquait pourquoi un groupe de clients échouait. Préférez un test contrôlé sur un poste et consignez toute purge réalisée.
Le cas fictif suivant illustre une migration incomplète. Une application recherche collecte-v1.service.example toutes les minutes. La configuration a été modifiée sur les postes récents, tandis que plusieurs anciens agents conservent ce nom supprimé. Les échecs se concentrent sur une même version, un même processus signé et un intervalle régulier. La correction doit viser le déploiement applicatif, sans créer une exception générale dans la surveillance.
Mesurer une anomalie à la bonne échelle
Comparez le nombre de requêtes échouées au volume total du même actif, sur la même période et le même capteur. Une hausse absolue pendant une multiplication des postes actifs n’a pas le même sens qu’un nouveau comportement sur un seul serveur.
Regroupez les noms par suffixe, puis examinez les valeurs individuelles. Des fautes de frappe répétées, des suffixes ajoutés automatiquement et des noms construits par une application ne demandent pas les mêmes actions. Gardez un échantillon représentatif, y compris des résolutions réussies proches des échecs.
La répétition seule ne prouve pas un mécanisme malveillant. Pour évaluer cette hypothèse, cherchez un processus inattendu, un parent inhabituel, une tâche récemment créée ou une séquence réseau corroborante. La méthode de corrélation entre DNS, IP et processus décrit les preuves nécessaires pour relier ces observations.
Prendre une décision qui résiste à la relecture
Une erreur de configuration établie appelle un correctif ciblé, un propriétaire et une vérification après déploiement. Un blocage attendu appelle la confirmation de la règle et de son périmètre. Une activité locale inexpliquée appelle une investigation du poste, même lorsque toutes ses requêtes échouent.
Dans le ticket, séparez les faits et les inconnues. Écrivez par exemple : « Le processus identifié demande un ancien nom de service ; les autorités ne le publient plus ; aucune autre destination n’a été examinée ». Cette phrase justifie la réparation sans prétendre avoir exclu toute compromission.
Pour un domaine public suspect, consultez son rapport de réputation et conservez le résultat daté avec votre collecte. Une réputation enrichit la décision ; elle ne remplace ni le statut DNS réellement reçu, ni l’identité du programme qui a lancé la recherche.
Questions fréquentes
- Que signifie NXDOMAIN dans une réponse DNS ?
- Le serveur indique que le nom demandé, ou la cible finale d’une chaîne CNAME, n’existe pas. Il faut identifier le serveur et les éventuelles politiques de filtrage avant d’interpréter cette réponse.
- Beaucoup de NXDOMAIN indiquent-ils un malware ?
- Pas nécessairement. Une configuration erronée, une application ancienne ou une liste de suffixes DNS peuvent produire des échecs répétés. Le processus émetteur et les noms recherchés orientent le diagnostic.
- Pourquoi NXDOMAIN persiste-t-il après une correction ?
- Une réponse négative peut rester en cache. Comparez les réponses des autorités DNS avec celles du résolveur concerné, puis vérifiez la durée de cache négatif et la configuration locale.
Articles associés
 CNAME cloaking : enquêter sur un sous-domaine tiers
Suivez la chaîne CNAME, identifiez le prestataire et contrôlez les cookies transmis avant de décider si un sous-domaine doit rester autorisé.
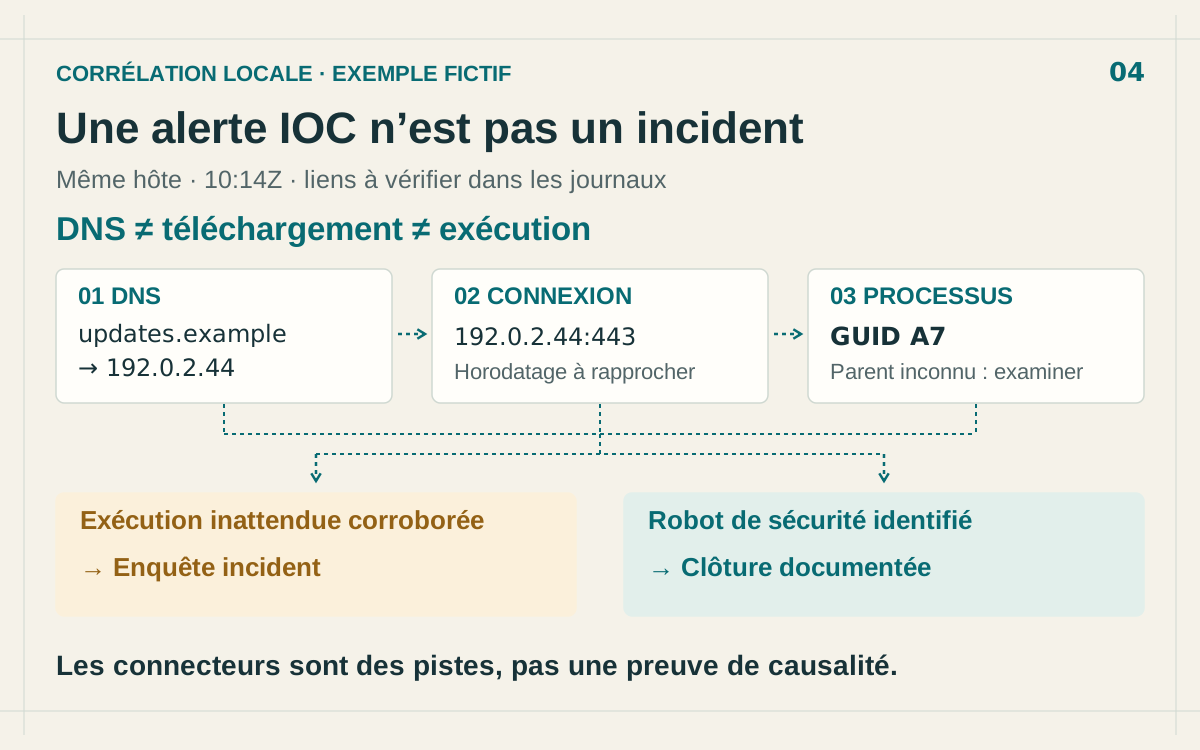 Alerte IOC : corréler IP, DNS et processus
Une correspondance IOC ne prouve pas une compromission. Reliez DNS, connexions réseau et processus pour vérifier ce qui s’est passé sur le poste.
 Fast flux DNS : détecter les infrastructures mouvantes
Détectez le fast flux DNS grâce au TTL, au DNS passif, aux ASN, à la réputation et à un workflow reproductible pour le SOC.
Protégez votre infrastructure
Confrontez n’importe quelle IP ou n’importe quel domaine à notre base de renseignement et à ses enregistrements indexés.
Essayer le vérificateur d’IP et de domaines